Az a fájl, amely minden ellenőrzést kiáll
A fájlbiztonsági folyamatok egy ritkán megkérdőjelezett feltételezésen alapulnak: egy fájlnak csak egy típusa van. Az észlelő meghatározza a típusát, a szabályzat pedig ennek megfelelően irányítja tovább. Ezután minden utána következő modul a fájlt ennek a típusnak megfelelően elemzi: a kártevő-elhárító, a sandbox és a tisztító modulok.
A többformátumú fájlok megcáfolják ezt a feltételezést. Egyetlen bájtfolyam egyszerre lehet teljesen érvényes GIF-fájl és teljesen érvényes Java-archívum is. Ugyanez a trükk működik egy olyan JPEG-fájl esetében is, amely egyben RAR-archívum is, vagy egy olyan PDF-fájl esetében, amely logikai vége után egy teljes ZIP-fájlt tartalmaz. Mindegyik rész önmagában megfelel a szabványoknak, így egyetlen formátum-elemző sem észlel semmilyen hibát.
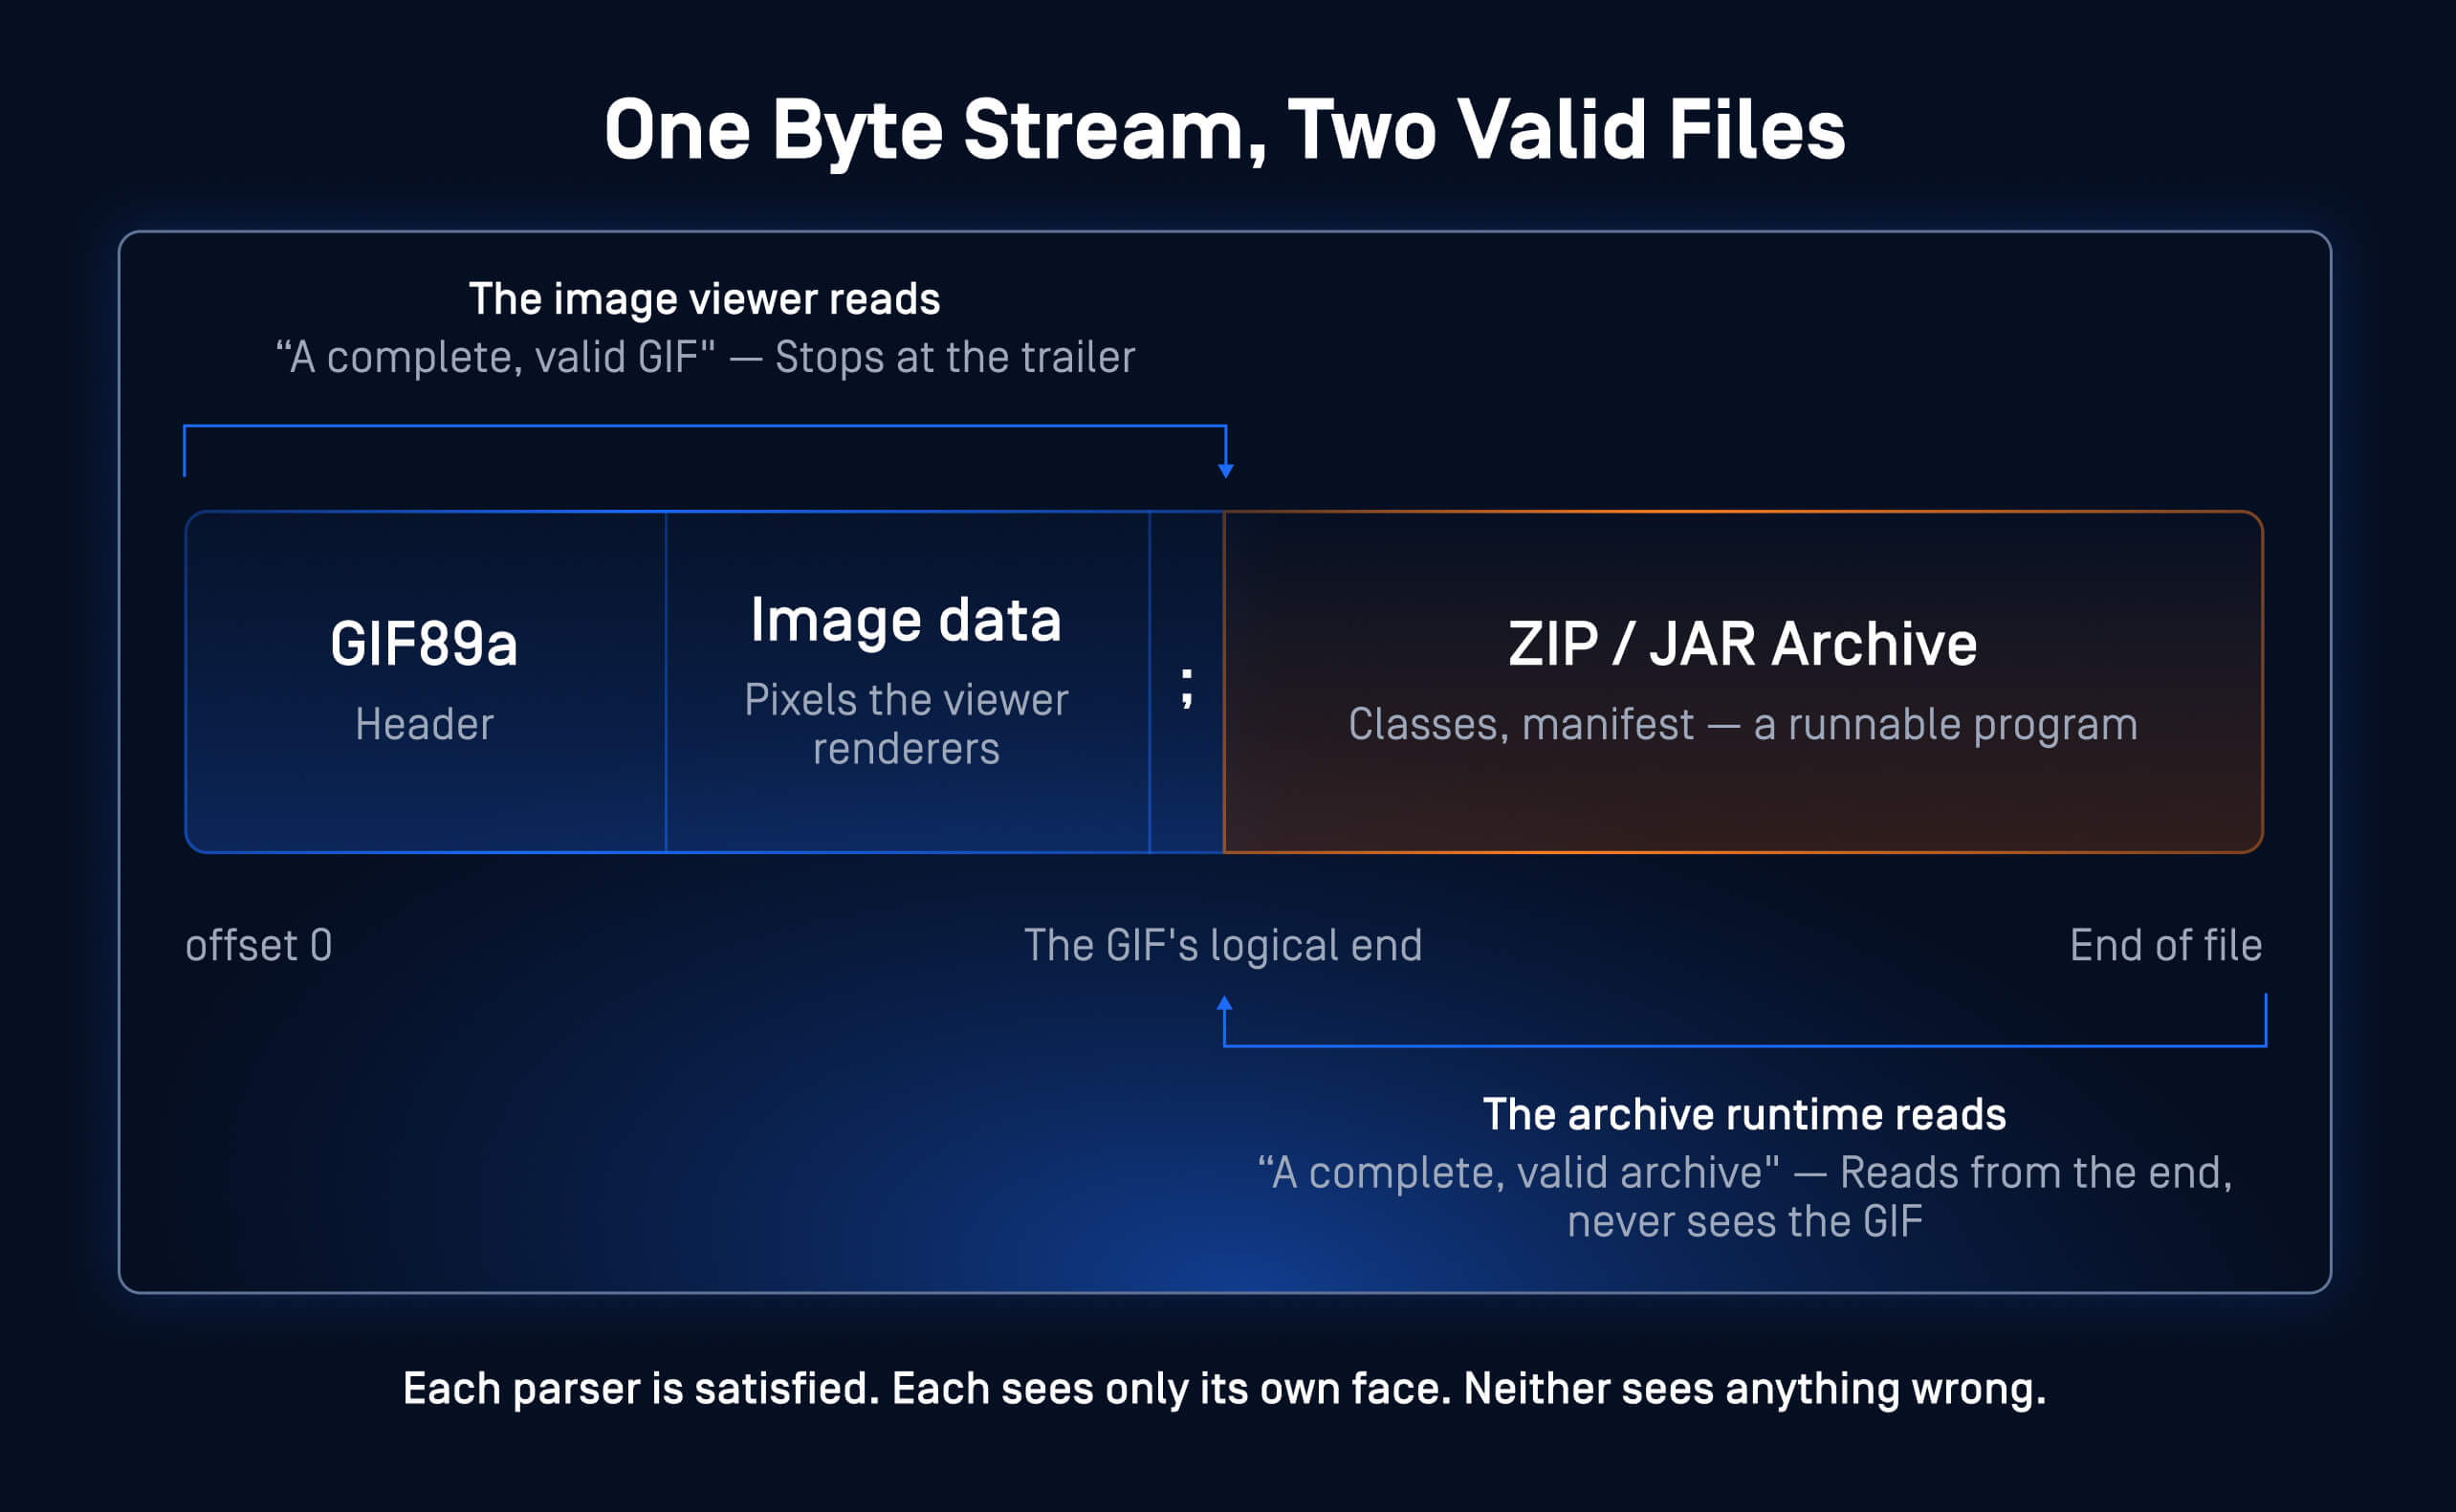
Egy képben a többnyelvűség: a klasszikus GIF+JAR. Két elemző, két belépési pont, egy fájl, és mindkét változat teljesen érvényes.
A biztonsági következmény egyértelmű: a feldolgozó folyamat az észlelt típusnak megfelelően vizsgálja át a fájlt, míg a másik formátum érintetlenül halad át rajta. Egy olyan kép, amely egyben szkript is, tárolt XSS-sé válik, amikor egy webalkalmazás visszaadja azt. A képburkolat mögé rejtett archívum a tartalomszűrőkön keresztül juttatja el a hasznos terhelését. Az ezen az elgondoláson alapuló támadási láncok – a klasszikus GIF+JAR kombinációtól a rejtjelzéssel támogatott kihasználási módszerekig – már közel két évtizede közismertek. A kártevőellenes motorok azonban nagyrészt nem veszik észre őket, mivel az egyes képek – külön-külön vizsgálva – ártalmatlanok.
Hogyan talál magának egy második arcot a motor?
Fájlszerkezet-ellenőrző motorunk a többnyelvűség felismerését előfeldolgozási lépésként építi be, amely minden beolvasott fájlon fut, még a formátum-feldolgozók előtt. A kialakítás három alapelvre épül.
- Az egész adatfolyamot átvizsgálja. A szkennelő a teljes fájlt összehasonlítja egy formátum-azonosító aláírásokból álló listával. Ha az adatfolyam bármely pontján egy második formátum jelenik meg, azt pontos eltolási értékével együtt jelzi, még akkor is, ha a fájl típusát már korábban azonosították. Ide tartoznak azok az aláírások is, amelyeket a PDF fájlvégi jelzője után fűztek hozzá, vagy amelyek egy kép pixeladatai mögé vannak elrejtve.
- Tudja meg, hol végződik jogilag egy formátum. A Container formátumok jogilag tartalmazhatnak más fájlokat. A ZIP-fájlban található kép egyszerű tartalomnak minősül. Az érzékelő a konténer saját szerkezetéből határozza meg az egyes konténerek valódi végét. A PDF-fájl zárószekciója, a ZIP-fájl központi könyvtára, valamint az OLE (Object Linking and Embedding) összetett fájl szektorallokációja jelöli ezt a határt. A PDF-fájlok feldolgozása figyelembe veszi az inkrementális frissítéseket is. Csak a struktúrán kívüli aláírások számítanak második határnak. Ez a strukturális határ az, ami megkülönbözteti a valódi többformátumú eredményt a minden szokásos archívum esetében fellépő téves riasztástól.
- Vádaskodás előtt ellenőrizze le! A rendszer az adatfolyamból kivonja az egyes jelölt adatokat, majd a jelentés előtt függetlenül újra azonosítja azokat a „File Type” motorunk segítségével. Azokat a jelölteket, amelyek strukturálatlan adatként azonosíthatók, a rendszer elveti. Az „ítélet” azt jelenti, hogy egy második formátum valóban értelmezhető az adott eltolási ponton. A véletlenszerűen előforduló mágikus bájtok önmagukban soha nem eredményeznek ilyen ítéletet.
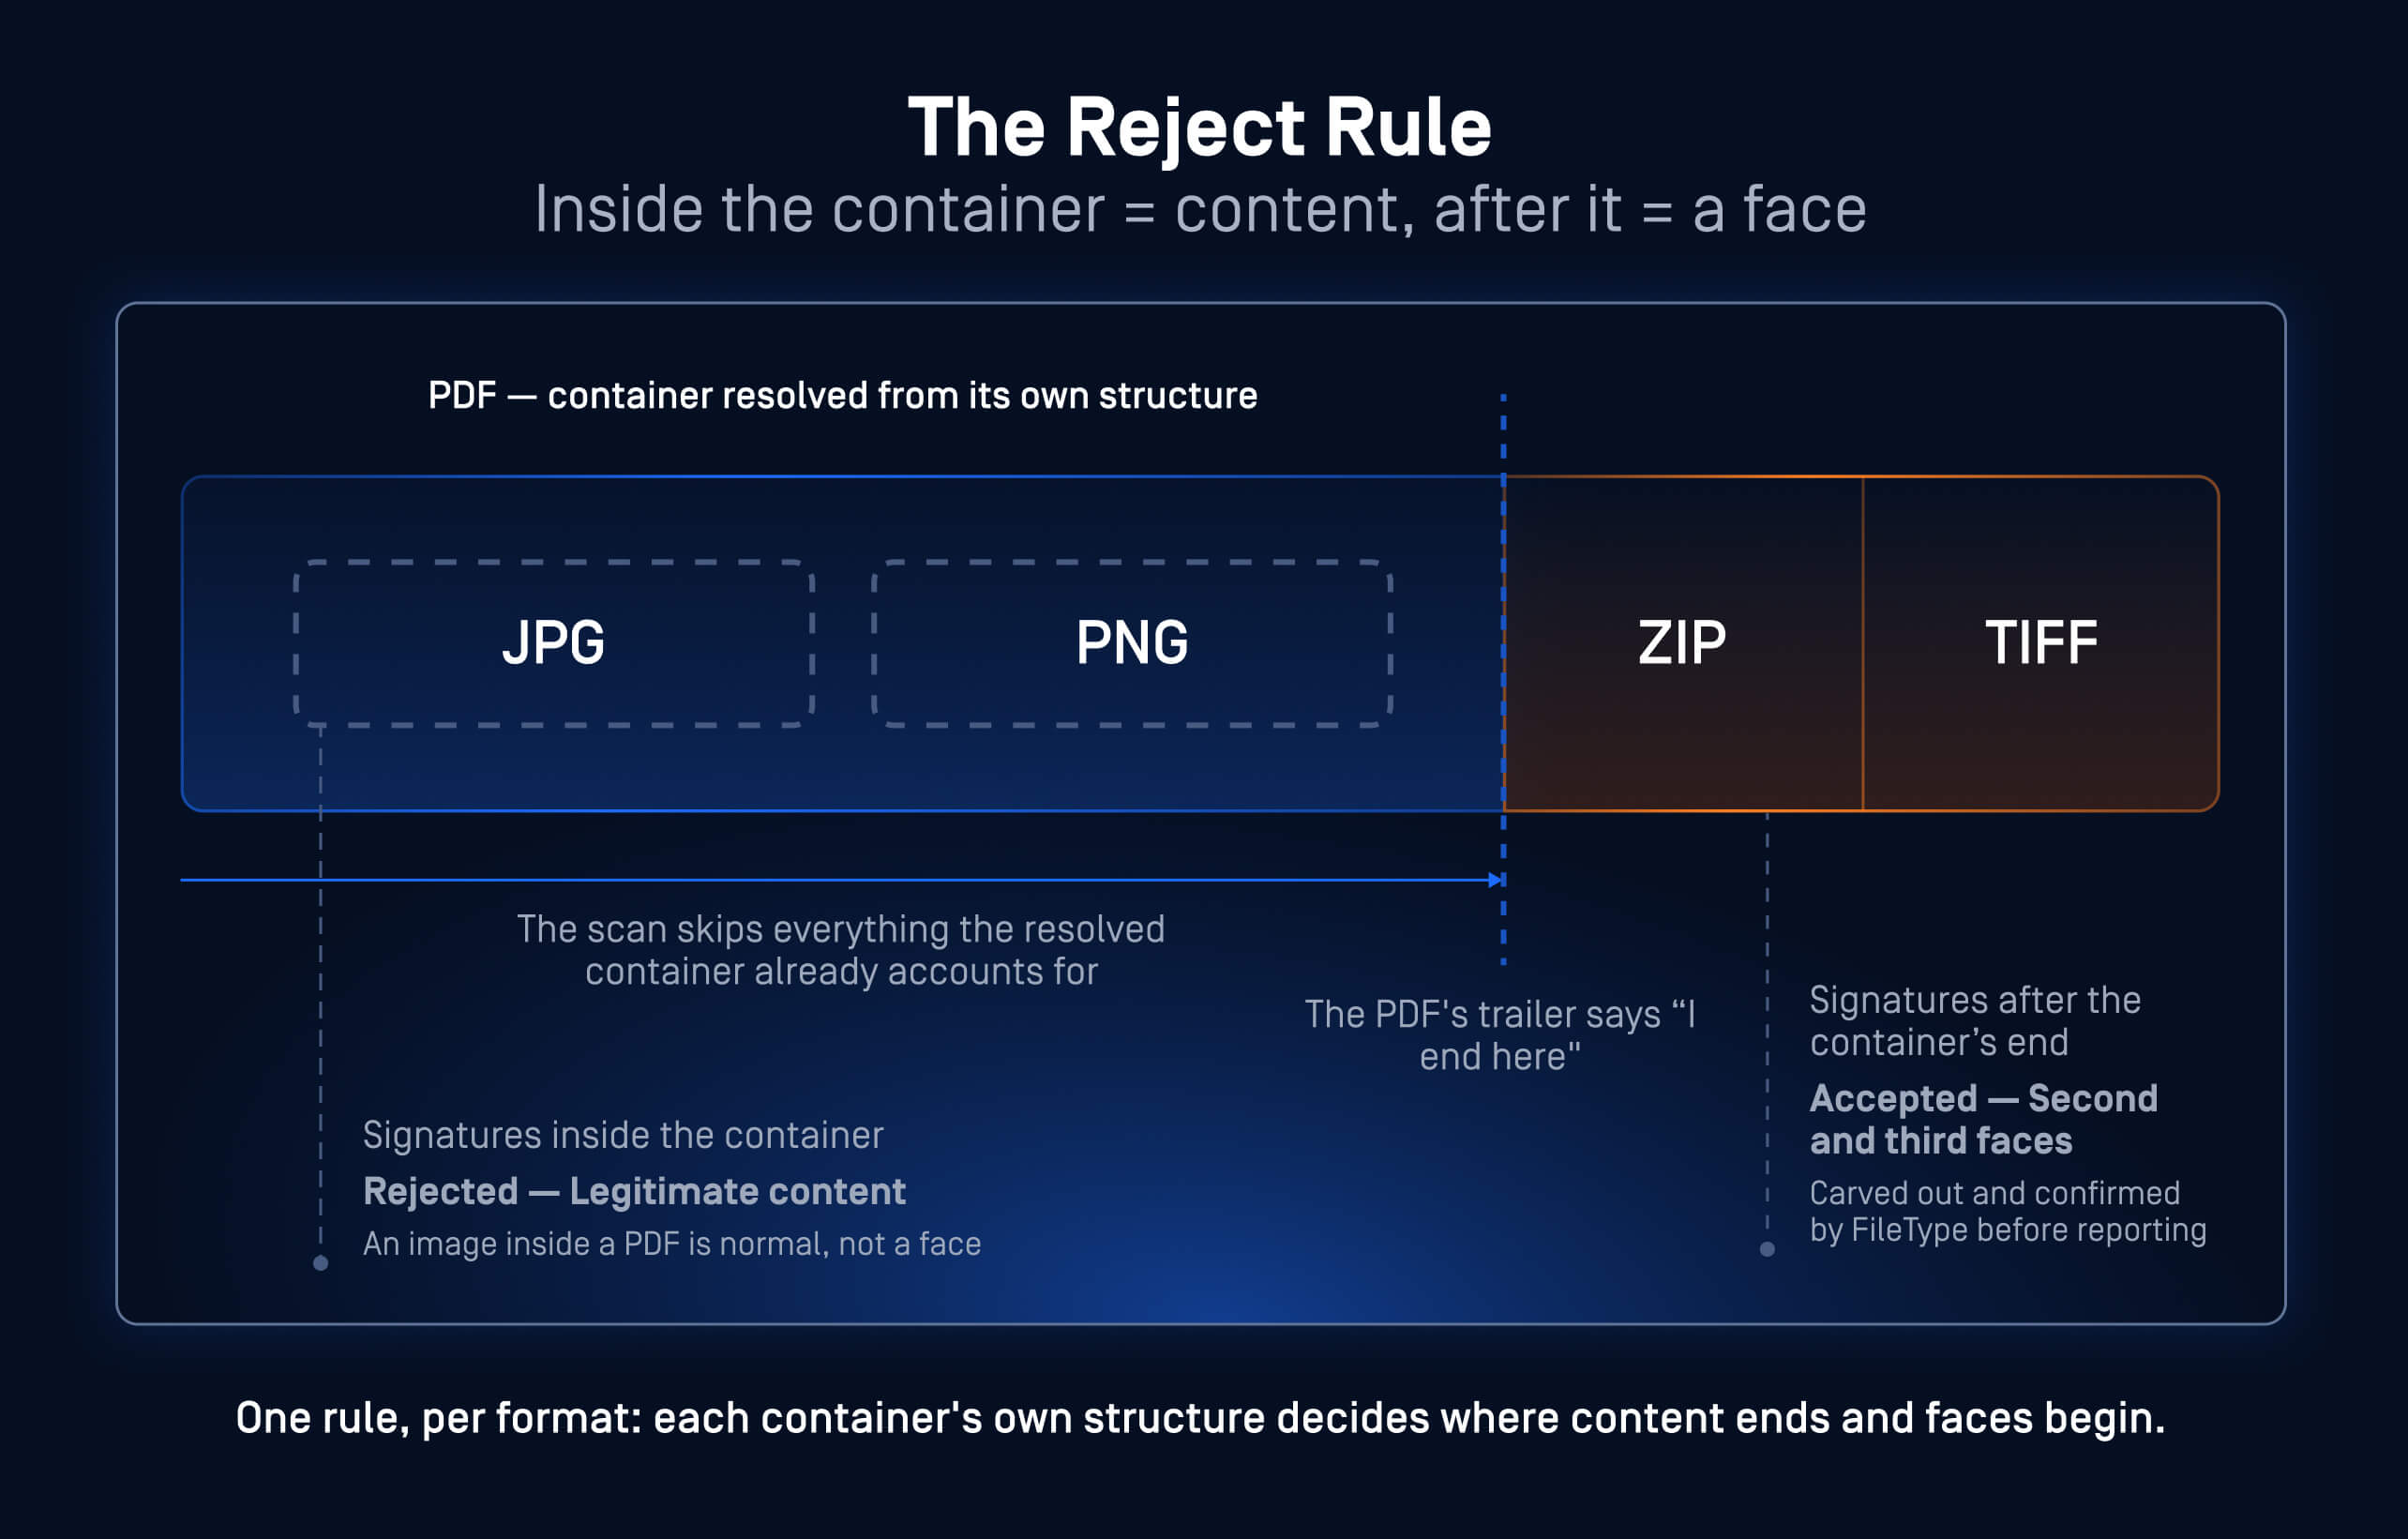
Valódi példából vettünk: egy PDF-fájl, amelybe egy JPG- és egy PNG-fájl van beágyazva, és amelynek logikai vége után egy ZIP- és egy TIFF-fájl is csatolva van. Az eredmény megnevezi a ZIP- és a TIFF-fájlt, a beágyazott képekről viszont nem tesz említést.
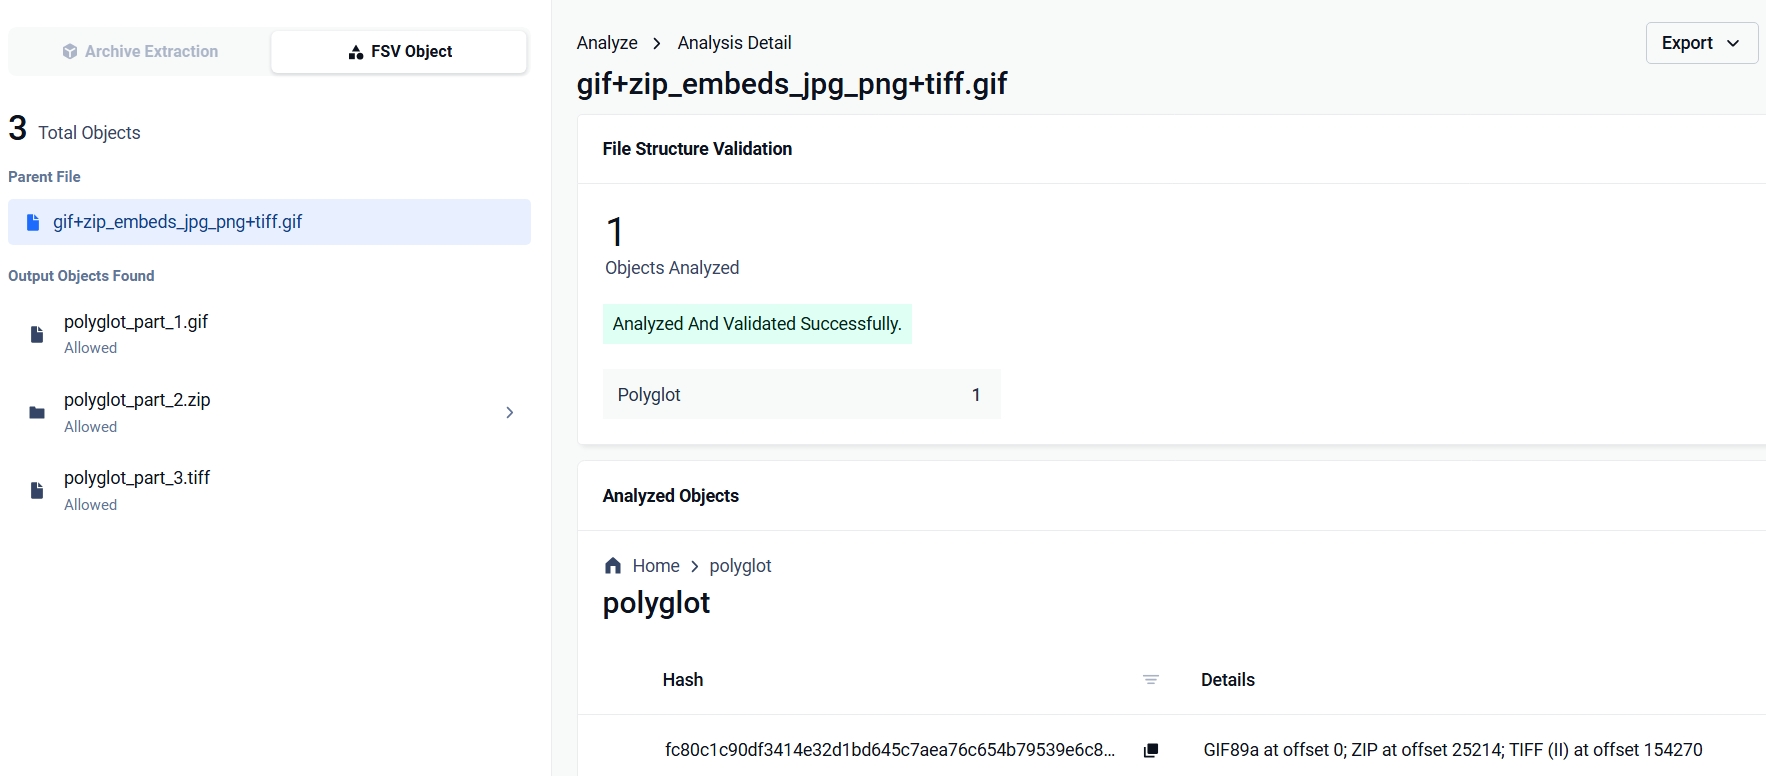
Az eredmény minden elemet az eltolási értékével együtt jeleníti meg. Például egy feltöltött .gif fájlt a rendszer a 0-s eltolási értéknél GIF89a-ként azonosít, míg a stream mélyebb rétegeiben ZIP-archívumként. A többit a szabályzat határozza meg: vagy jelentse az eredményt, vagy azonnal blokkolja a fájlt, és adjon magyarázatot az találatok felsorolásával.
A felismeréstől a boncolásig
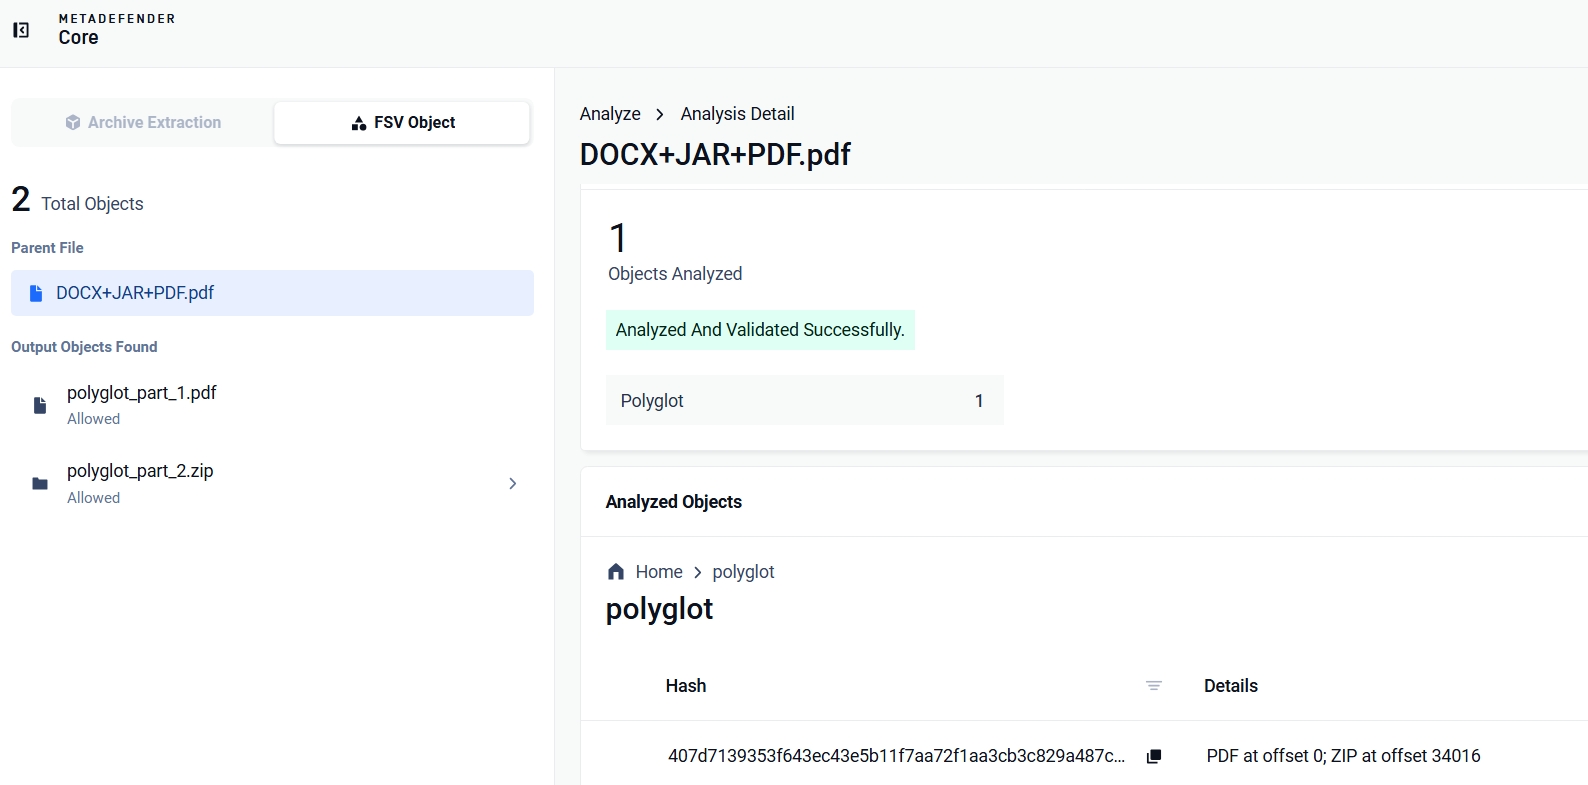
Az észlelés csak a megoldás fele, mert a Polyglot trükkje éppen abban rejlik, hogy az egyes elemek önmagukban ártalmatlannak tűnnek. Az észlelés után a motor felbontja a fájlt. Minden megerősített elemet külön objektumként exportál (polyglot_part_1.pdf, polyglot_part_2.zip stb.), a formátumával, eltolásával és méretével együtt. A motor mindegyiket visszajuttatja az MetaDefender Core™ munkafolyamatba, hogy az azokat valódi jellegüknek megfelelően teljes körűen feldolgozza.
Ezt végpontok között egy működő MetaDefender Core™ példányon ellenőriztük.
A motor egy titokban Word-dokumentumot tartalmazó PDF-mintát (egy PDF+JAR+DOCX többformátumú fájlt) két részre bontotta: a PDF-rétegre és a ZIP-rétegre. Mivel a JAR és a DOCX egyaránt ZIP-tárolóformátumok, egy ZIP-réteg eleget tesz mindkét specifikációnak. A fájltípus-motor ezt követően a réteget DOCX-ként azonosította, majd a Deep CDR™ technológia azt külön-külön megtisztította. A rejtett réteg pontosan azt a kezelést kapja, amelyet elkerülni szándékozott.
A pontosság a legnehezebb rész
A „mágikus bájtok” természetesen előfordulnak ártalmatlan fájlokban is, ezért a valódi mérnöki erőfeszítés abban rejlik, hogy ne riasztassunk feleslegesen. A fényképezőgépekkel készített fotókba beágyazott EXIF-miniatűrök saját JPEG-aláírást hordoznak. Az Office-dokumentumok a konténer-szerkezetükbe ágyaznak be képeket. Az „ Media ” fájlok véletlenszerűen tartalmaznak olyan bájtsorozatokat, amelyek tömörítési fejlécekre hasonlítanak. Az észlelési logika kizárja azokat a bájtokat, amelyekről egy legitim struktúra már gondoskodik, és ezt a biztonsági megerősítést formátumról formátumra folyamatosan bővítik. Egy olyan észlelőt, amely minden fényképet jelöl, kikapcsolnak, és egy kikapcsolt észlelő senkit sem véd.
Valódi többnyelvűekkel tesztelve
Valódi, többnyelvű mintákat futtattunk le egy élő MetaDefender Core™ telepítésen a File Structure Validation motor segítségével. Mindegyiket észlelte a rendszer, és mindegyikhez pontosan megadta a bájtpozíciót:
Példa | Talált arcok (eltolás) | Eredmény |
Word-dokumentum elrejtése PDF-ben (PDF+JAR+DOCX egy fájlban) | PDF: 0 · ZIP: 34 016 | Az arcok kivonásra kerültek; a rejtett DOCX-fájl a Deep CDR™ technológiával megtisztításra került |
GIF, amely egy archívumot és egy második képet rejt el | GIF89a @ 0 · ZIP @ 25 214 · TIFF @ 154 270 | Észlelve |
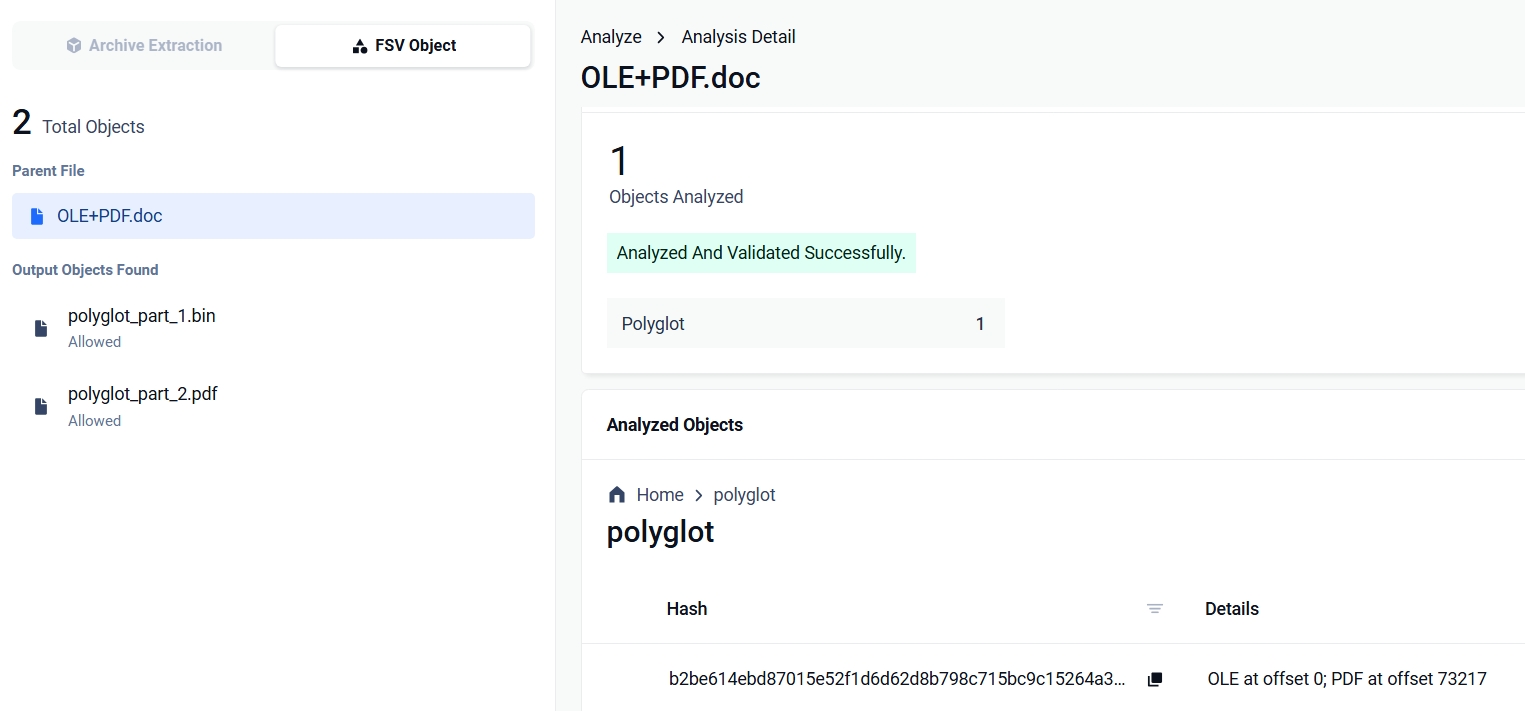
PDF-fájlt rejtő Office-dokumentum | OLE @ 0 · PDF @ 73 217 | Észlelve |
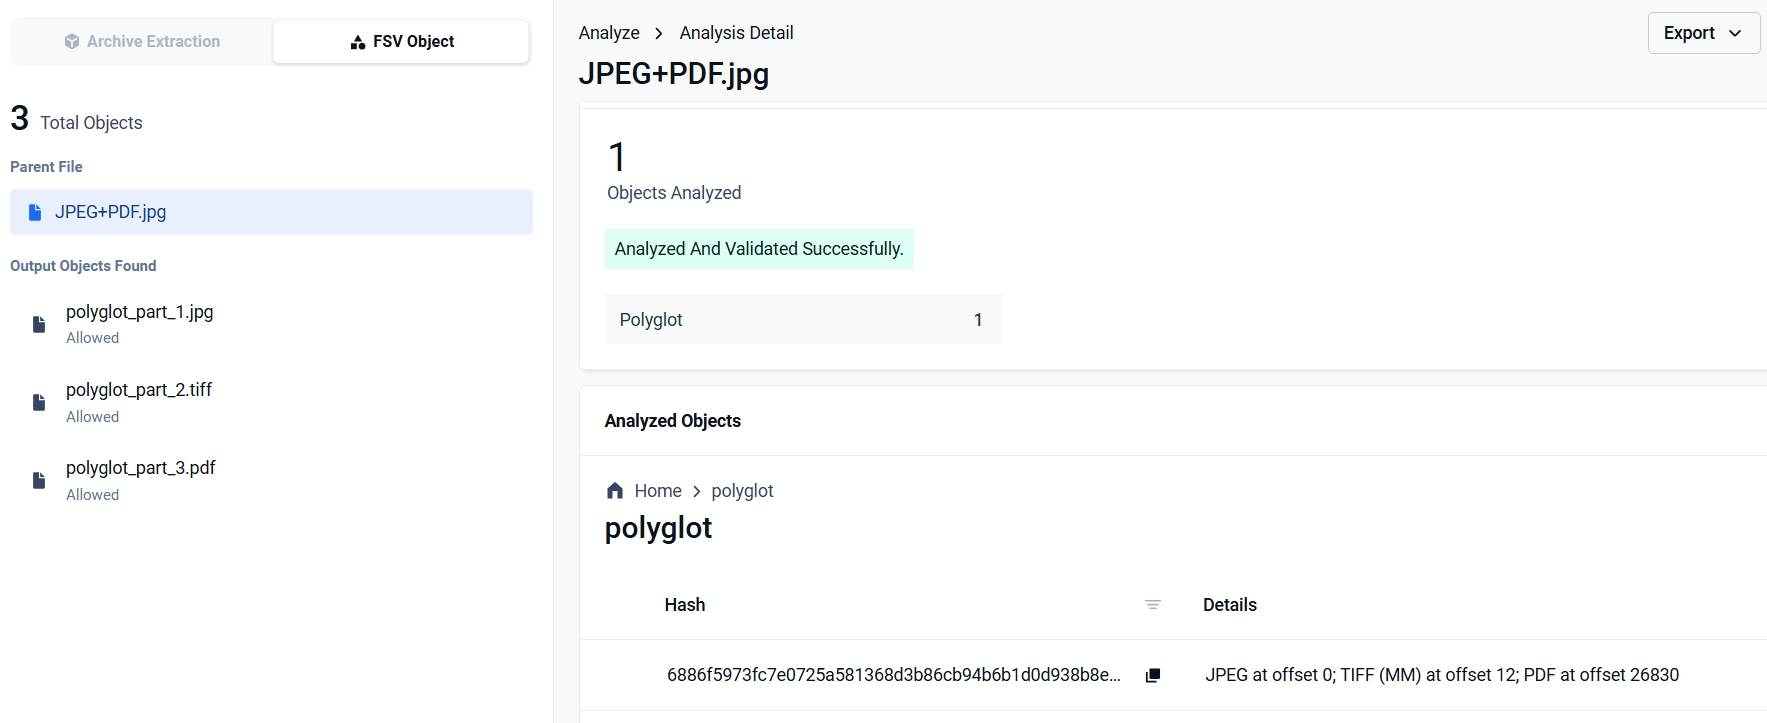
JPEG-fájlba rejtett PDF | Három arc, PDF csatolva @ 26 830 | Észlelve |
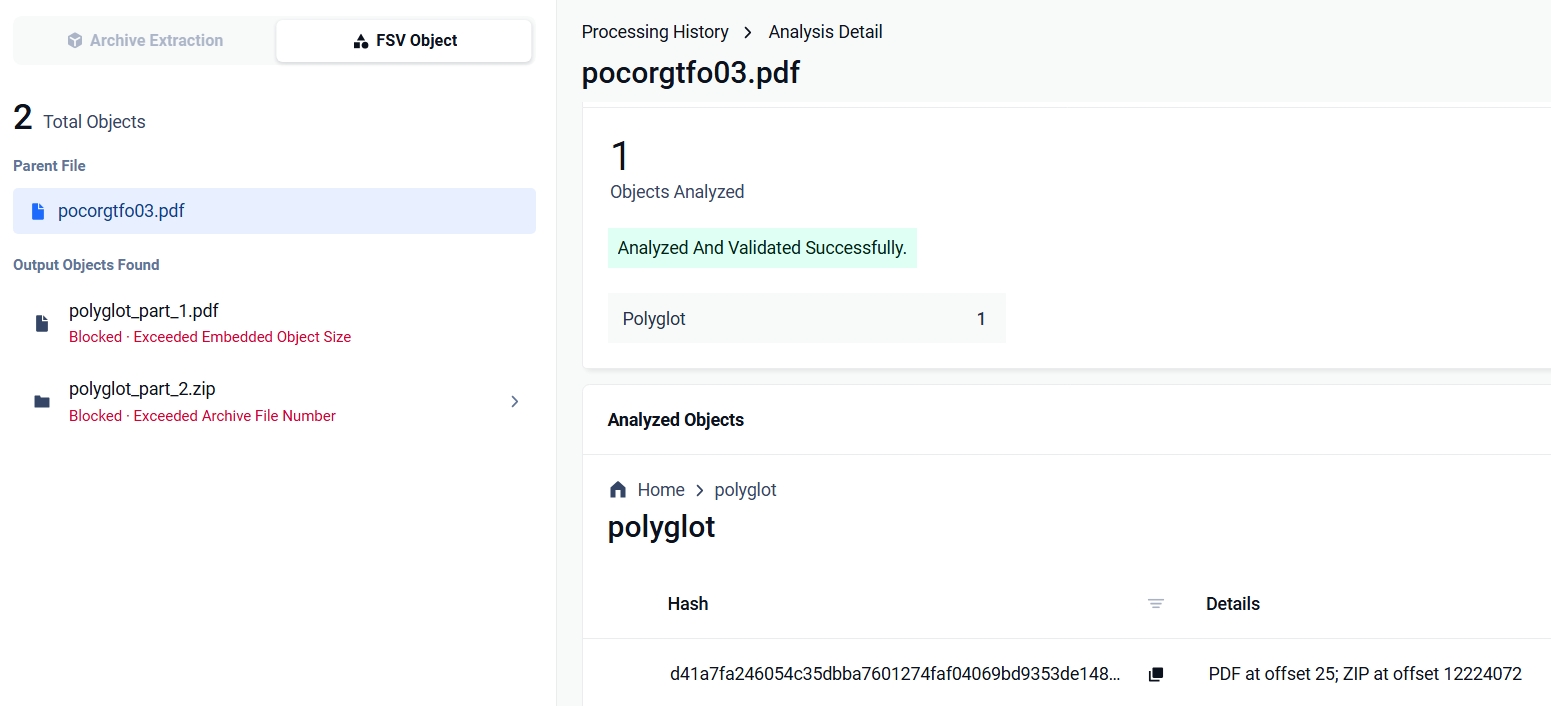
„PoC‖GTFO” 3. szám, a biztonsági kutatásokkal foglalkozó magazin, PDF+ZIP formátumban, több nyelven, 26 MB | PDF: 25 · ZIP: 12 224 072 | Észlelve: a teljes vizsgálat során 12 MB mélységben találtak egy második arcot |
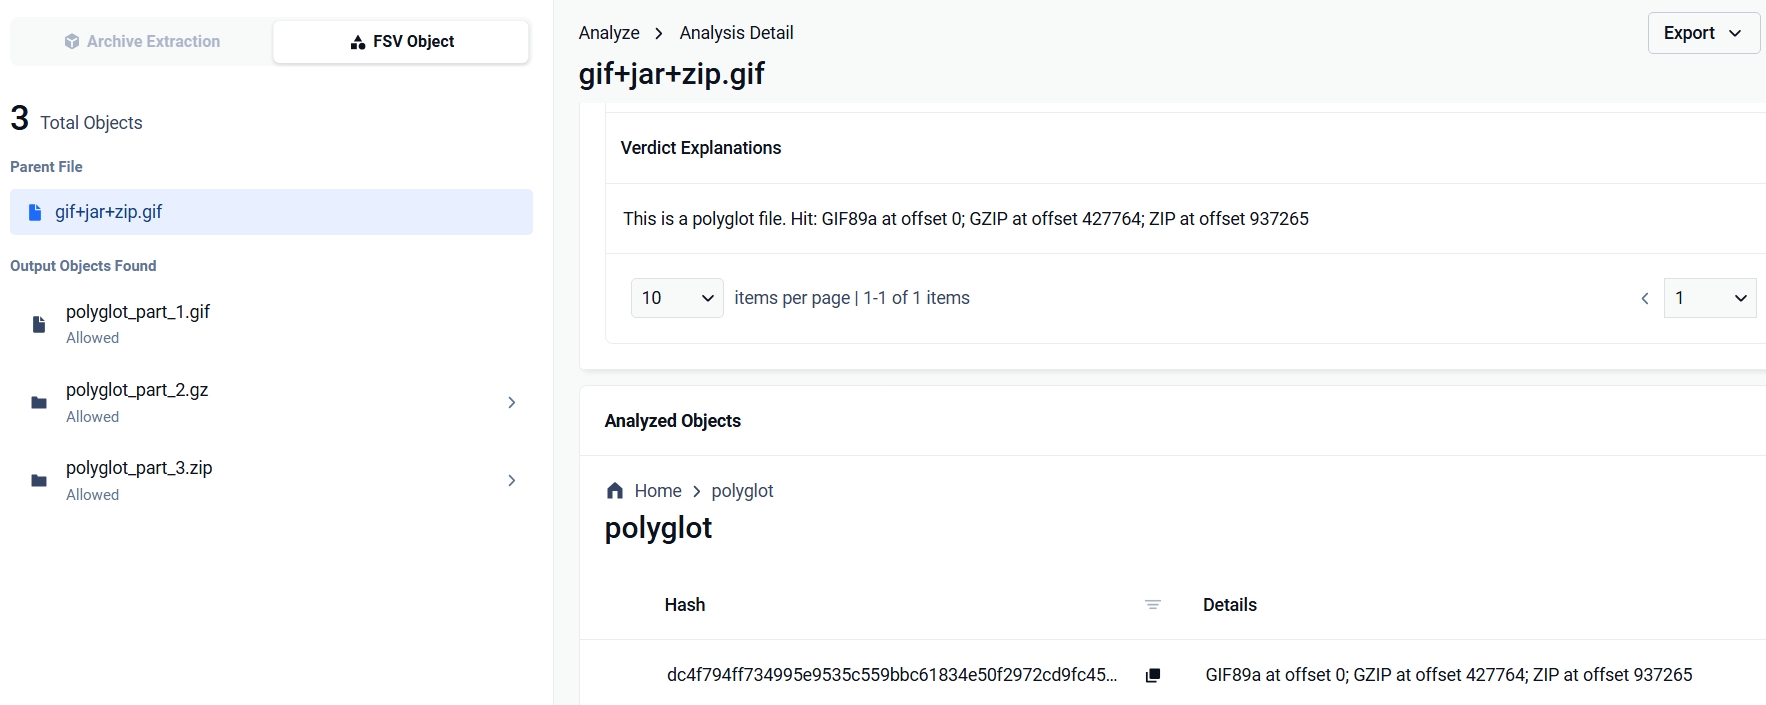
GIF, amely egy GZIP-adatfolyamot és egy Java-archívumot tartalmaz | GIF89a @ 0 · GZIP @ 427 764 · ZIP @ 937 265 | Letiltva |
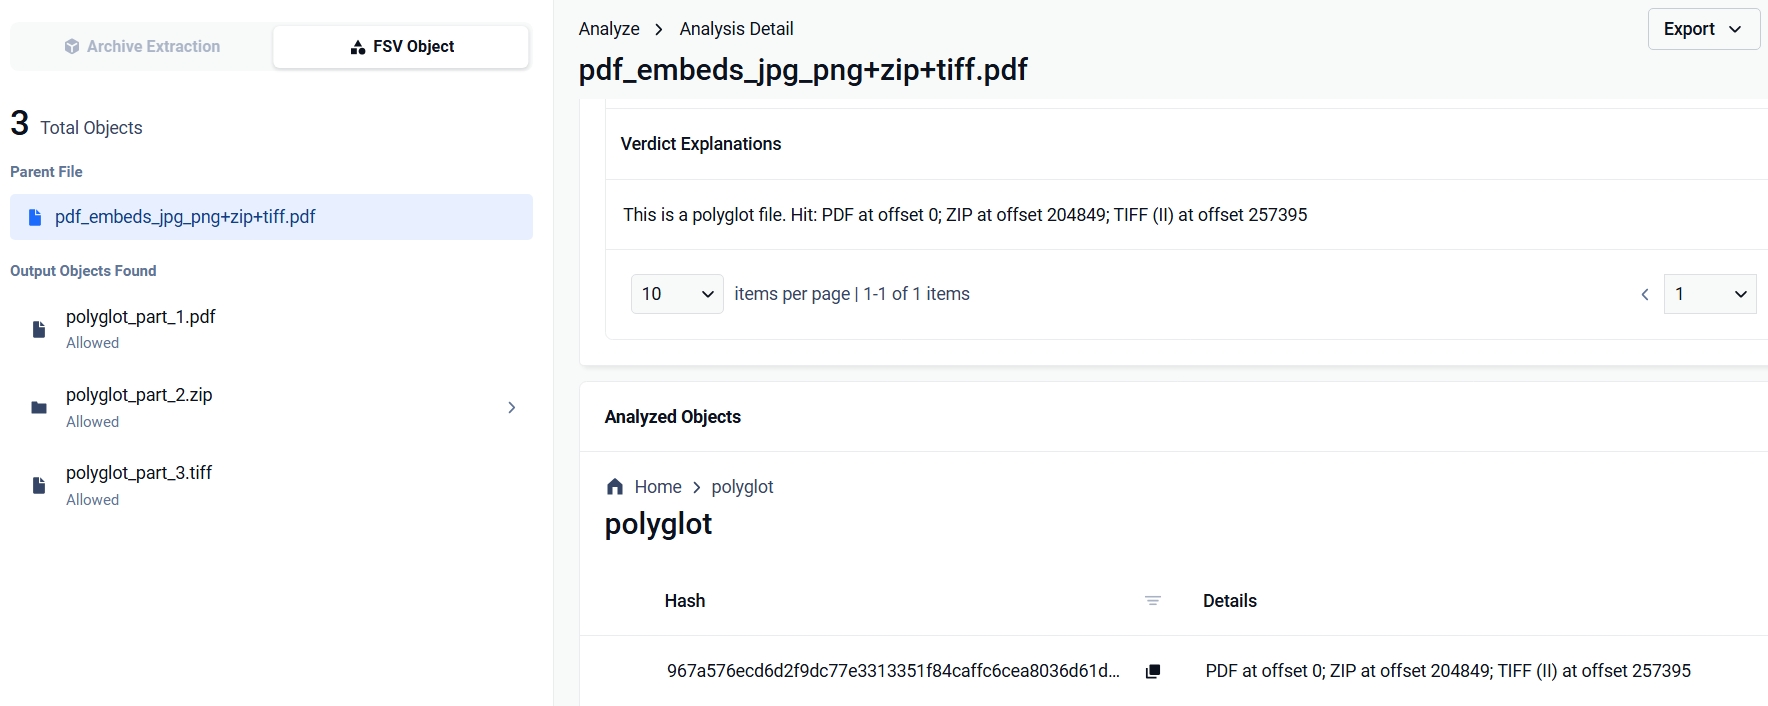
PDF, amelybe egy JPG- és egy PNG-fájl van beágyazva, és amelyhez egy ZIP- és egy TIFF-fájl van csatolva | PDF: 0 · ZIP: 204 849 · TIFF: 257 395 | Blokkolva; a beágyazott képek helyesen nem kerültek jelentésre |
Az utolsó sorban látható, hogyan működik az elutasítási szabály: az ítélet megnevezi a csatolt ZIP- és TIFF-fájlokat, és figyelmen kívül hagyja a PDF-ben található képeket. A konténer-feloldó ezeket a PDF saját tartalmának tekintette. Az MetaDefender Core™ ezen fájlra vonatkozó JSON-eredménye (rövidítve):
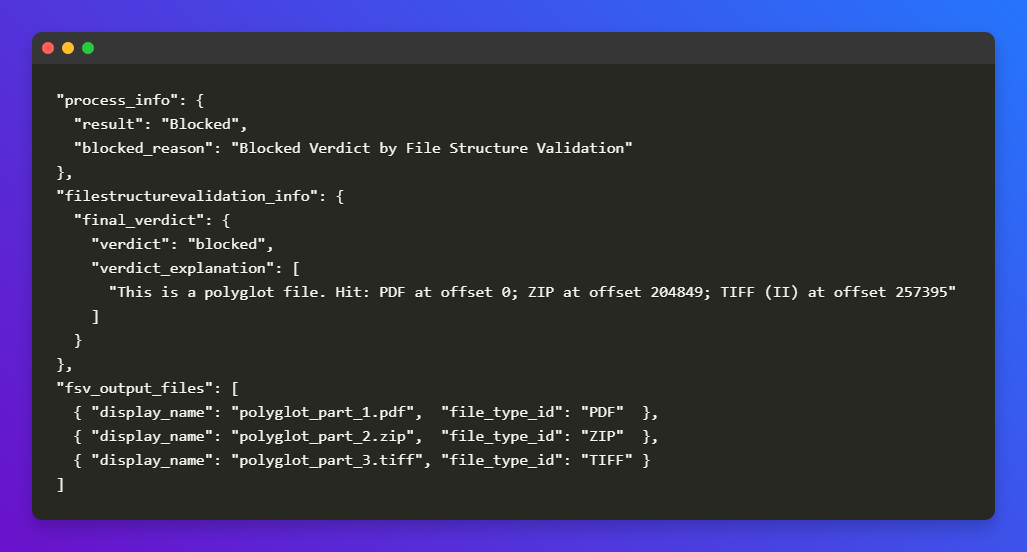
Az fsv_output_files lista a fent leírt felboncolás élő formában: a három felületet kivágják, és önálló objektumként visszajuttatják a munkafolyamatba.
Íme az egyes mintaeredményekről készült képernyőképek az „ MetaDefender Core™” szoftverből:
Lefedettség és konfiguráció
A jelenlegi támogatás kiterjed azokra a formátumokra, amelyeket a támadók ténylegesen kombinálnak: PDF, ZIP, OLE összetett fájlok, PNG, GIF, JPEG, TIFF, RAR, GZIP és 7z.
A konténer végének szerkezeti felbontása a konténerformátumokra vonatkozik. A funkció „konfiguráció-első” elven működik: az észlelés, a blokkolás és a teljes fájl átvizsgálása egyaránt szabályzati kapcsolók, így az üzemeltetők telepítésenként dönthetnek a láthatóság és a kényszerítés között.
A lényeg
Egy két érvényes felületet tartalmazó fájl meghiúsítja minden olyan feldolgozási folyamatot, amely egyetlen típust rendel hozzá, és a legtöbb beolvasási rendszer éppen az egytípusú felismerésen alapul. A strukturális többnyelvű felismerés pótolja ezt a hiányosságot azzal, hogy minden felületet megtalál, és igazolja, hogy mindegyik értelmezhető. A szabályzat ezután letilthatja a fájlt, mielőtt bármely alkalmazás rossz értelmezőt választana.
A leggyakoribb támadási formátumok felismerése már ma is támogatott. A fennmaradó archívumformátumok esetében a konténer végének feloldása a fejlesztési tervben szerepel.
Nézze meg, hogyan kezeli a File Structure Validation a környezetében áthaladó fájlformátumokat.